香港的標通常判給「完全符合而索價最低」的那一份,所以評標的工時大半花在合規,不在打分。這也正好是 AI 做得到的那一半:逐份標書對照編號檢查表、標出條款與頁碼、把六份報價表拉平到同一個基準。分數留在評審手上,廢標的決定也一樣。
本頁內容
市場上賣 AI,賣的通常是「打分」。一個會按技術優劣替標書排序的模型,回答的是大多數採購團隊從來沒有問過的問題;評分制確實存在,但它是例外,而且主要用在工程合約。他們真正在問的,是那幾百項逐條比對的合規審查——由一兩個人、在一天最累的時候、對著六家格式各異的標書做完。
六家投標者、四十項的報價表、三頁強制條件,只是一個中等規模的標。它同時是幾百次核對,而任何一次沒核到,那份標書就結束了。
AI 評標七成的工時,花在「符合」這兩個字上
強制條件很少只寫一次。它寫在投標者須知裡,又在規格書裡出現一次,再在投標表格裡出現一次,最後還跟著最後一週發出的補遺再改一次。漏掉一項的投標者,不會變成「比較弱的投標者」——按《物料供應及採購規例》,缺少「必要要求」的標書在規則上就是不合規,部門不得回頭向投標者補問那份文件。廢標也不是評審小組的權限:未經所屬投標委員會批准,部門不得廢標,更不會憑軟件的判斷廢標。
這個權責分工比它看起來重要。正因為廢標是委員會的決定,每一次廢標都要答得出一個問題:哪一條條款、標書第幾頁、哪一句不合格。「技術要求未符合」不是答案。經辦人要的是條款編號、頁碼,以及過不了的那句原文。
為了拿到這些證據而逐頁翻,是機械工作,但錯一次的代價很高。它同時也是那種工作:機器最明顯的短處——它不會在最後一天晚上九點開始疲倦——比它的「智能」更值錢。
這份工作之所以長期被低估,是因為它不產出任何看得見的東西。一次順利的合規審查,留下的是一份乾淨的報告,以及沒有人記得的那個下午。所以它總是落到最資淺的同事手上,也所以在它失手之前,沒有人會想起它。
《規例》對「偏離」寫得很清楚:附屬投標委員會若不把合約判給最低合規價的那一份——或者在設有評分制的標裡,不判給總分最高的那一份——就要在該月月底把詳情與理由呈交中央投標委員會。偏離不是禁止的,是要被記錄的;也就是說,理由必須在判給之前就寫得出來,而不是事後補。
AI 該做什麼、不該做什麼
採購團隊問「工具該放在哪裡」時,我們用的分工是下面這張表。請先讀最後一欄,再讀第三欄。
| 環節 | 評審仍要自己決定的事 | AI 做得好的事 | 不能交出去的事 |
|---|---|---|---|
| 合規審查 | 某項偏離是否屬於重大偏離 | 逐份對照編號檢查表,標出條款與頁碼 | 逕自判定標書不合規 |
| 資格與經驗 | 某個業績參考是否真的可比 | 從完工證明抽出日期、金額與證明文件 | 把不存在的業績當成事實 |
| 報價對齊 | 比較應該用哪一個基準 | 把稅、幣種、單位、交期、備件年數拉平 | 決定評審基準 |
| 技術評分 | 分數本身,以及給分的理由 | 加總、驗算、標出缺漏的佐證 | 替評審寫給分理由 |
| 澄清 | 某個答覆是否改變了標書 | 依它找到的缺口擬問題,並記錄往返 | 判斷答覆的實質影響 |
| 判給 | 建議,以及向委員會解釋的能力 | 把標記、決定、經手人、時間整理成紀錄 | 作出建議 |
表裡每一行,只要容許工具自行決定,日後就有人要替一個不是自己做的決定辯護。那不是技術風險,是治理風險——那也是第三欄刻意沒有寫滿的原因。
三個真正拉開差距的動作
先把招標文件拆成編號檢查項
在條件變成一張清單之前,什麼都核不了:一條要求一行、附條款出處、寫成答得出「是/否」的檢查項。多數機構會在這一步發現,同類型的標他們其實跑著三份略有出入的檢查表,而正在用的不是最新那份。把三份併成一份,比買軟件值錢。
先把報價表拉平,再比錢
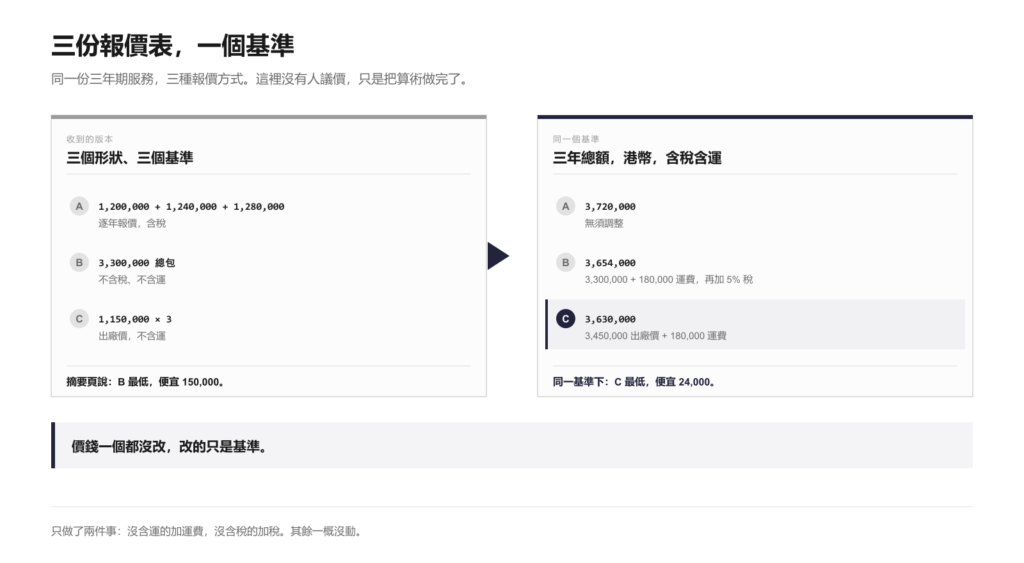
兩份標書在摘要頁上看起來差三分之一,一旦基準對齊,可能只差幾個百分點。常見的元兇是稅、幣種、計量單位、交貨條件、備件含幾年,以及選擇性項目到底有沒有報價。把這些拉平是算術——而在一天最累的時候做算術,正是最不該由人來做的事。
最典型的例子,是一家按年報價、另一家報三年總包的服務合約;或者一家報出廠價、另一家報送到並安裝妥當的價格。兩邊都不是在做手腳,都是正常的商業慣例——而兩者都會讓摘要頁說謊。
每一個標記都要指得回某一頁
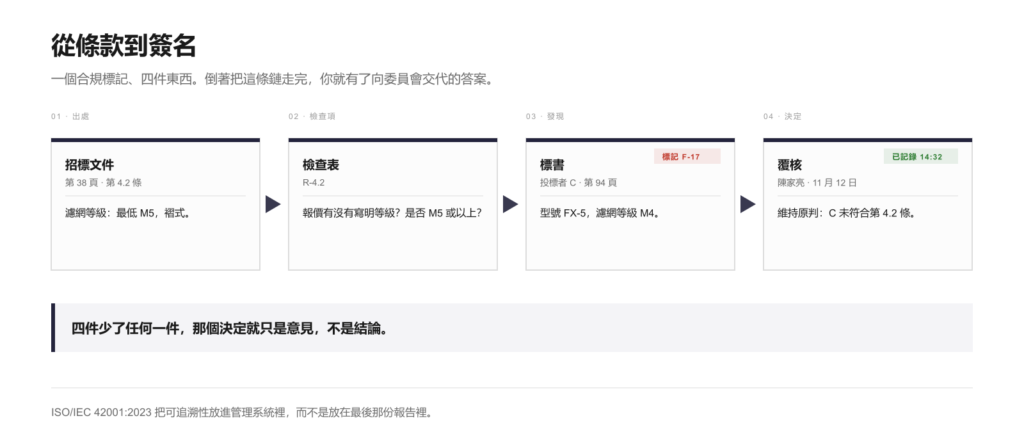
一個標記要能用,前提是它帶著證據。只看到「第 4.2 項未符合」,評審會去查、會去爭,或者乾脆不看。看到條款和頁碼,同一位評審十秒內就能決定。這個出處同時讓「覆核」變得可審計——這才是必須堅持的理由。
在工具進來之前,先把規則寫進流程:沒有出處的標記不算標記,沒有署名的覆核不算覆核。
澄清階段,是紀錄最先斷掉的地方
澄清這一段,看起來像往來書信,實際上是證據。投標者被要求解釋某個價格、或確認某個交期,三天後用電郵回覆。那個答覆有沒有改變標書,是評審要下的判斷;而它之所以重要,是因為一旦澄清改變了標書的實質內容,它就不再是澄清了。
無論有沒有 AI,這裡都會壞在兩件事上。一是問題問得太寬,寬到答覆等於重寫報價,而直到有落選者來問,才有人發現;二是整段往返住在某位經辦人的信箱裡,從來沒有進到評審報告。補救方法很無聊:每個問題都要由一個具體缺口生成,每個答覆都要掛回產生它的那個標記,每一輪都要編號。供應商投標流程往往就卡在同一個位置,原因一樣——門戶記住了遞交,卻忘了對話。
把每一輪編號,成本是零,卻能解決日後大部分「當時到底問了什麼」的爭議。它也擋掉了另一種更安靜的失誤:五家投標者被問了五個略有出入的問題,然後那五個答覆被當成同一個問題的答案來比較。
四種會出錯的方式
以下四種都不是模型問題,全部是流程問題——而且沒有一種會在演示裡出現。
| 失敗方式 | 當日現場長什麼樣 | 代價 |
|---|---|---|
| 把一致當成正確 | 每一輪都是同樣三家被標記,於是沒有人再細看 | 真正的偏離被放過去 |
| 只給結論,不給依據 | 一句「不合規」,沒有條款、沒有頁碼 | 評審只好自己從頭再做一次 |
| 由工具決定廢標 | 標書在委員會看到之前就被擱下 | 一個你答不出來的質疑 |
| 覆核沒有紀錄 | 為了趕報告,把標記悄悄清掉 | 無法證明有人真正判斷過 |
第四種,是會一路走到委員會面前的那一種。當建議偏離「最低合規價」時,委員會必須看到理由,而那份紀錄還要經得起一年後由一個不在場的人來讀。如果工具的產出只是一個沒有軌跡的結論,評審會在三星期後憑記憶把軌跡重建一次——而記憶不是紀錄。
同一個問題還有一個二階版本,值得單獨點出來,因為多數試點都死在這裡:工具先在供應商提供的乾淨 PDF 上測試,然後遇上真實標書——歪著掃描、第 94 頁還有手寫修改。圍標偵測撞的是同一堵牆:分析的上限,就是掃描器放過來的那些東西。
eTender 在 AI 評標裡做哪兩件事
評標模組做的就是那兩件不漂亮的事。它把招標文件讀成一張要求清單,逐份標書對照,回傳的標記帶著條款與頁碼,而不是一句結論。另一邊,它把各家的報價表拉進同一張表,讓比較建立在一個基準上,而不是六個。
評分留在評審手上,法規本來就是這樣規定,任何說得過去的 AI 評標也該如此。系統留住的是把一次評審變成審計軌跡的那一部分:誰接受了某個標記、誰推翻了它、什麼時候、憑什麼證據。eTender 的招標管理模組把同一份紀錄帶過整個週期,標書檔案與評審檔案因此是同一份檔案。而在設備合約裡,這裡核定的備件年限與保養條款,簽約那天就成為企業資產管理系統裡的紀錄。
買任何東西之前,先做這個測試
拿你上一份做完的標。把招標文件裡的強制條件印出來,然後計時:一位經辦人核完一份標書要多久,而且每一項發現都要寫下條款和頁碼。再乘以你收到的標書數目。
如果答案不到一小時,你暫時不需要它。如果答案是一天,你已經知道自己要買的是什麼了——你也知道它不是那個分數。至於電子招標系統怎麼選,多數團隊是從評分模組開始看的,因為那是最容易演示得好看的一部分。
每個供應商都問同一條問題:讓我看一份上個月工具判斷錯了的標書,以及是誰推翻它的。答不出這個的演示,演示的是一個評分引擎——而評分引擎,正是這篇文章花了近三千字勸你不要先買的那個東西。